
它是什麼
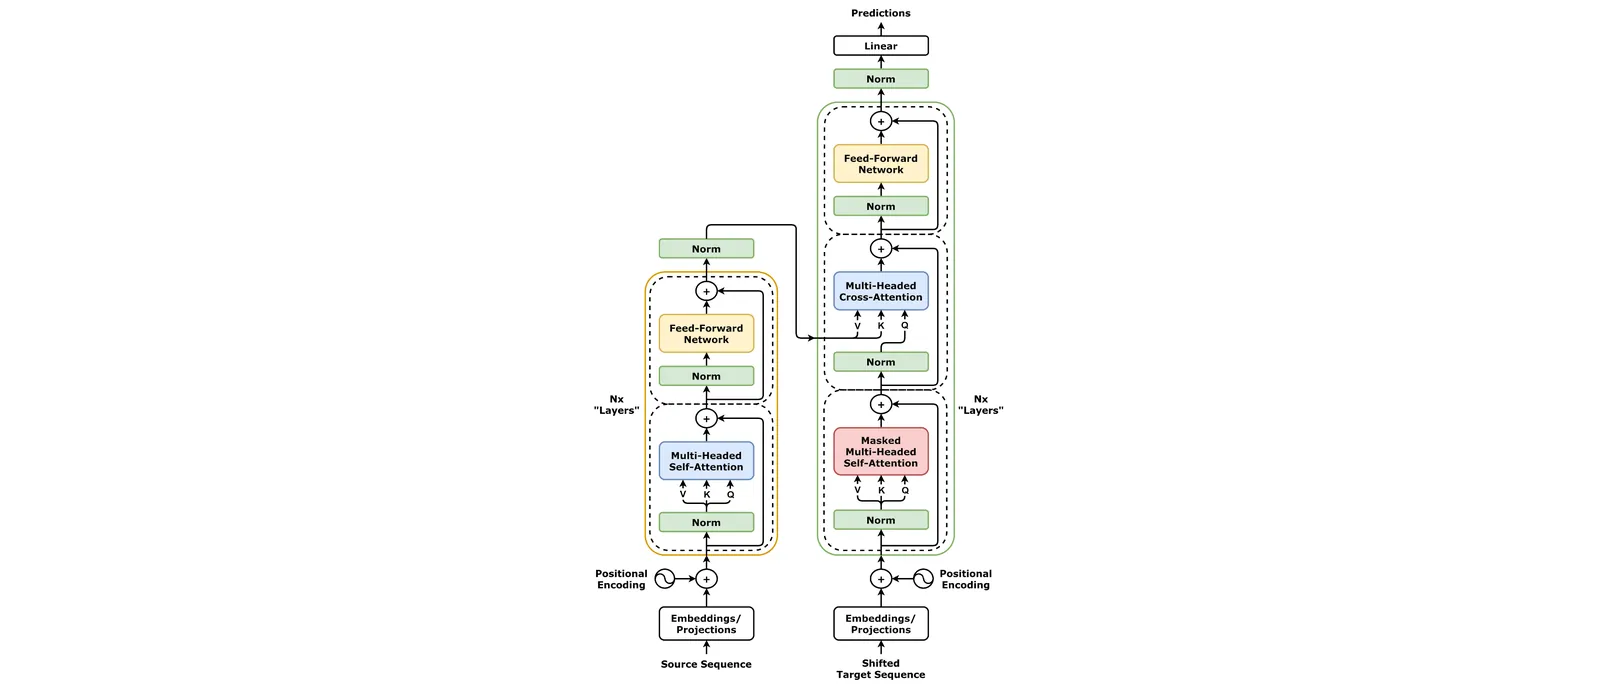
首先,文字被切成稱為 token 的小片段,通常是完整的字詞或字詞的一部分。核心步驟稱為注意力(attention)。對每個 token,模型會衡量它與文字中其他 token 的關聯強度,這就是它判斷「它」這類字指的是什麼的方式。最後,它為每個可能的下一個 token 評分,從可能性高的選項中挑一個,加進去,再重複一遍。
在做到這些之前,模型要先經過訓練。它會看到非常大量的文字,並反覆調整自己,直到預測越來越準。這就是它能寫出流暢自然文章的原因,也是它主要弱點的來源。模型產生的是看似合理的文字,而不是查證過的事實,因此它可能以同樣平靜的口吻,說出虛假與真實的內容。Claude 與 OpenAI 的 ChatGPT 等工具就是這樣打造的。
為什麼這對企業很重要
- 流暢不等於正確:寫得很好的輸出仍可能是錯的,因此事實、數字與引文都需要查證。
- 您的資料:使用代管的模型時,您的文字會送到供應商處理,因此請決定哪些內容可以分享。
- 成本:用量通常以 token 計算,因此輸入與輸出越長,費用越高。
- 人工審閱:凡是要送到客戶手中或寫入紀錄的內容,都應由內行的人先行閱讀。
這在我們的工作中如何體現
在我們的 AI 與自動化服務中,我們依每項任務選擇模型,對重要的輸出保留人工把關,並協助客戶決定哪些資料可以送出。若想進一步了解能自行行動的工具,請閱讀代理式 AI。
相關服務
瞭解更多
- 維基百科的 Transformer 條目對這個設計的技術概述,適合想深入了解的讀者。
- 維基百科的大型語言模型條目對這類模型如何建構與使用的中立介紹,適合作為起點。








