
它是什么
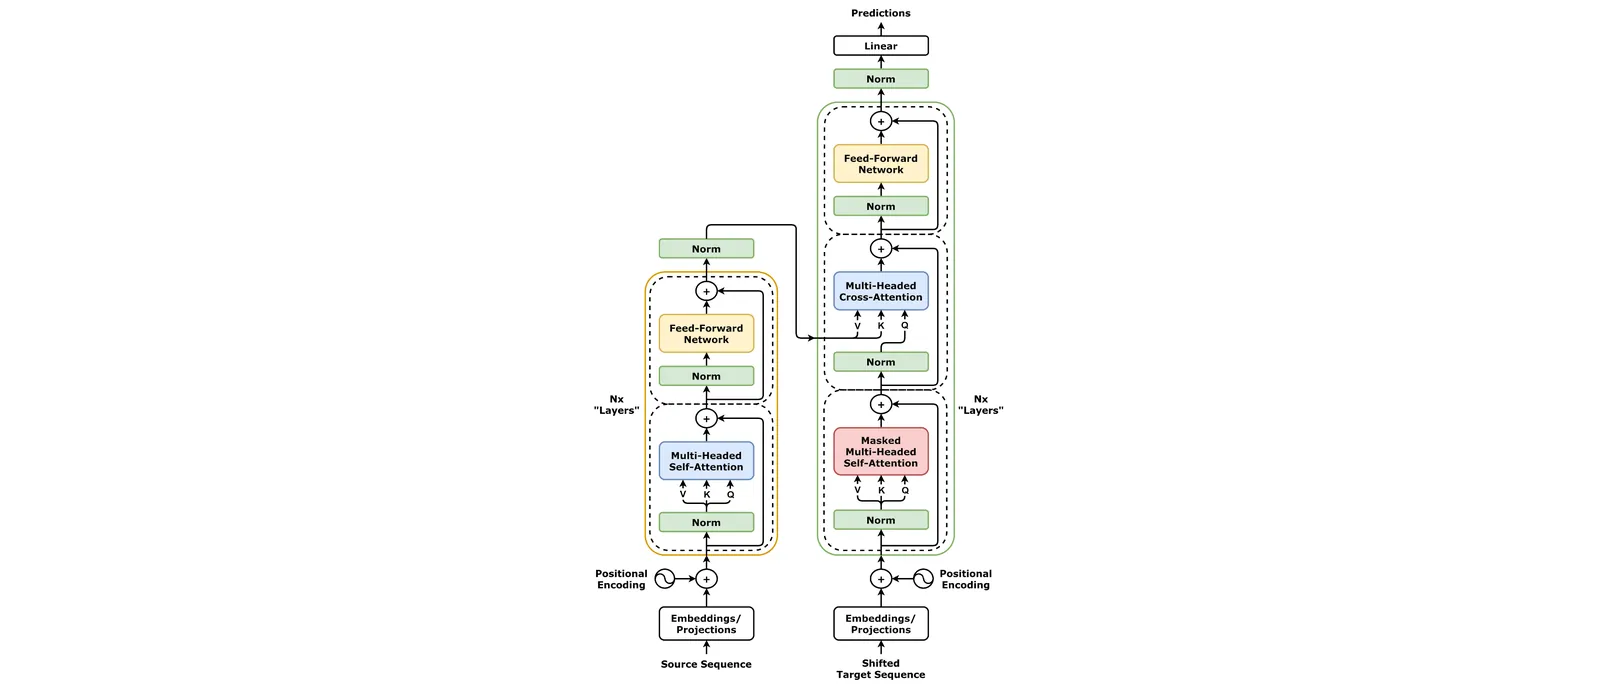
首先,文本被拆分成称为 token 的小片段,它们通常是完整的词或词的一部分。核心步骤称为注意力(attention)。对于每个 token,模型会衡量它与文本中其他 token 的关联强度,这就是它弄清“它”这类词指代什么的方式。最后,它为每一个可能的下一个 token 打分,从可能性较高的几个中选一个,加上去,然后重复这一过程。
在能做到这些之前,模型要先经过训练。它会看到海量文本,并反复调整自身,直到预测越来越准。这就是它能写出流畅自然文字的原因,也是它主要弱点的来源。模型生成的是看似合理的文本,而不是查证过的事实,因此它会用同样平静的语气,说出错误的内容和正确的内容。Claude 以及 OpenAI 的 ChatGPT 等工具都是这样构建的。
为什么它对企业重要
- 流畅不等于准确:写得好的输出也可能是错的,因此事实、数字和引文都需要核对。
- 您的数据:使用托管模型时,您的文本会被发送给服务商处理,因此要决定哪些内容可以共享。
- 成本:用量通常以 token 计量,因此输入和输出越长,费用越高。
- 人工审核:任何会送达客户或写入记录的内容,都应由懂行的人阅读。
这在我们的工作中如何体现
在我们的 AI 与自动化工作中,我们为每项任务选择模型,对重要的输出保留人工环节,并帮助客户决定哪些数据可以发送。如需更深入了解能够自主行动的工具,请阅读智能体 AI(agentic AI)。
相关服务
了解更多
- 维基百科上的 Transformer 词条对该设计的技术概述,适合想深入了解的读者。
- 维基百科上的大语言模型词条对这类模型如何构建和使用的中立介绍,适合作为起点。








